AudioX: چارچوب یکپارچه تولید صدا از متن، ویدیو و صوت
منتشرشده: · بهروزرسانی: · فناوری
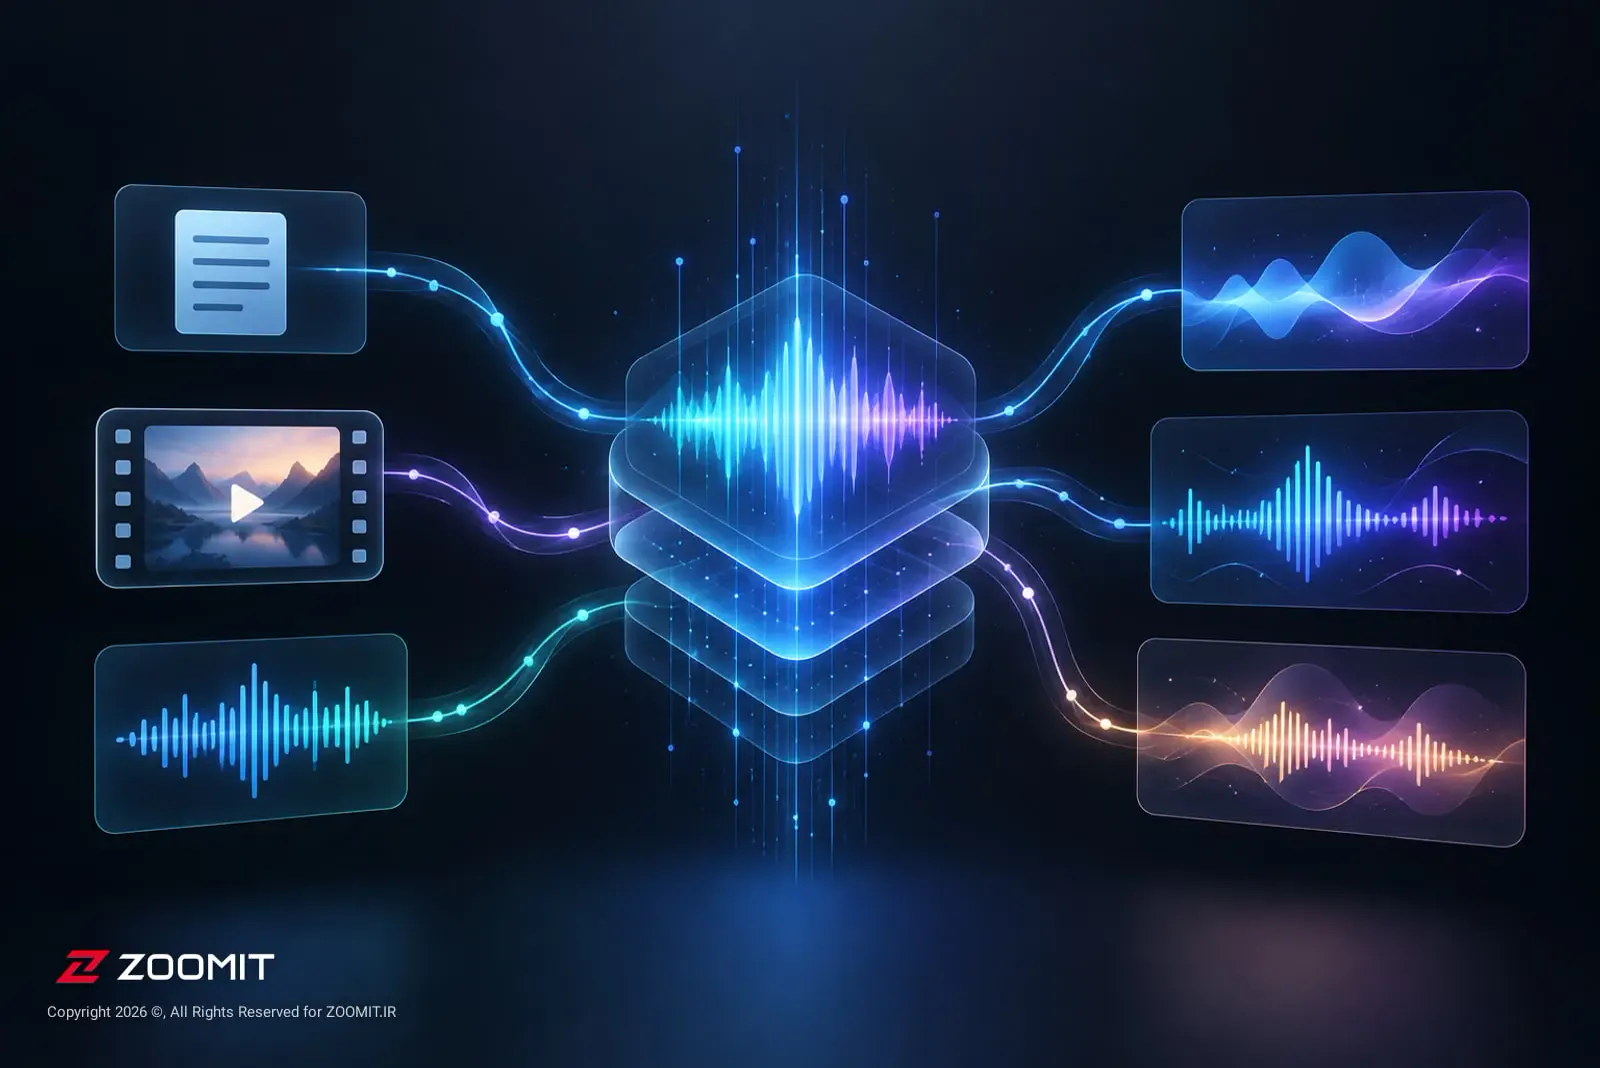
پژوهشگران مدل AudioX را معرفی کردند که امکان تولید صدا و موسیقی از ورودیهای متنوع را در یک سامانه فراهم میکند.
محققان حوزهٔ هوش مصنوعی چارچوبی به نام AudioX توسعه دادهاند که قابلیت تولید صدا و موسیقی را از ورودیهای متنوعی نظیر متن، ویدیو و سیگنالهای صوتی در یک سامانهٔ واحد فراهم میکند.
در این پروژه، ماژول جدیدی به نام ادغام تطبیقی چندوجهی (MAF) طراحی شد تا ترکیب ورودیهای نامتجانس را بهبود بخشد و هماهنگی میانوجهی دقیقتری ایجاد کند.
برای آموزش مدل، پژوهشگران دیتاستی شامل بیش از ۷ میلیون نمونه تحت عنوان IF‑caps گردآوری و منتشر کردند.
AudioX در پلتفرم هگینگ فیس به صورت سه نسخهٔ مجزا منتشر شد: مدل پایه، نسخهٔ مجهز به ماژول تلفیق AudioX‑MAF و نسخهٔ پیشرفتهتر AudioX‑MAF‑MMDiT. ارزیابیهای اولیه نشان داد که این ساختار در وظایف متن‑به‑صدا، متن‑به‑موسیقی و پیروی از دستورهای پیچیده عملکرد قابل توجهی دارد.
کدهای منبع، وزنهای مدل و دموی تعاملی برای پژوهشگران در دسترس است. اجرای آفلاین این مدل نیازمند محیط پایتون نسخهٔ ۳٫۸ و بالاتر، ابزارهای مانند FFmpeg و کارت گرافیک سازگار با محاسبات هوش مصنوعی است.